MIRA
Ich bringe einer Kamera bei, Abfall auseinanderzuhalten. Es ist Computer Vision, angewendet auf ein Recyclingproblem, das ich wirklich anfassen kann.
Warum es existiert
MIRA steht für Machine Intelligence for Recycling Automation. Es begann mit einer einfachen Frage: Kann eine günstige Kamera mit einem kleinen Modell verschiedene Abfallarten gut genug unterscheiden, um beim Sortieren zu helfen? Das langfristige Ziel ist automatisches Sortieren. Das kurzfristige Ziel ist bescheidener, dafür aber nützlicher: Ich will herausfinden, wie nah die aktuellen Modelle daran wirklich sind.
Deshalb bin ich beim Schreiben so genau. Das Projekt ist als deutsche Forschungsarbeit für Jugend forscht aufgeschrieben, und ich versuche, Arbeit und Code aufeinander abgestimmt zu halten. Alles, was ich über ein Ergebnis schreibe, muss deshalb sagen, was gemessen wurde, auf welchen Daten und was es nicht zeigt.
Wie es funktioniert
MIRA ist eine Pipeline vom einzelnen Foto bis zur Live-Kameraansicht. Ich habe sie in zwei Stufen gebaut, und die zweite hat das Projekt stärker verändert, als ich erwartet hatte.
Stufe A: Kann ein Modell die Materialien unterscheiden?
Am Anfang standen selbst gesammelte Fotos: 796 Bilder in vier Klassen. Zuerst trainierte ich ein kleines eigenes CNN, aber dann übernahm ein vortrainiertes MobileNetV2. Das feinabgestimmte MobileNetV2 erreichte etwa 87 % Validierungsgenauigkeit, und eine INT8-TFLite-Version davon behielt diese Genauigkeit bei nur 2,6 MB Dateigröße.
Das zeigte, dass sich die Materialien unterscheiden lassen, aber es blieb eine Lücke. Ein Klassifikator gibt jedem Foto genau ein Etikett. Er kann also sagen: „Das ist Plastik“. Ein Sortierer muss aber auch wissen, wo das Plastik liegt und ob es drei Flaschen oder eine sind. Diese Lücke hat mich zur Stufe B gebracht.
Stufe B: Wo liegt das Objekt?
Stufe B ist der Wechsel von der Klassifikation zur Detektion. Ich habe mit YOLOv8n angefangen und dann auf YOLO11n gewechselt. Trainiert habe ich mit Ultralytics auf Kaggle und auf Colab-GPUs vom Typ T4, 120 Epochen bei 640 Pixeln.
Es gibt fünf Klassen: Glas, Metall, Papier, Plastik und Trash. Die Trainingsdaten kommen aus vier Quellen: TACO, TrashNet (mit SAM beschriftet), dem Trash-Detection-Datensatz von Roboflow und einem Datensatz von dmedhi. Ein Skript baut daraus den endgültigen Satz mit festem Seed, SHA-256-Prüfung gegen Duplikate und einem Herkunftsnachweis. So kann ich bei jedem Bild sagen, woher es stammt. Am Ende stehen 6.898 Bilder mit 12.832 Boxen, klassenausgeglichen. Eine Quelle, WaRP, habe ich wieder herausgenommen, weil sie die Ergebnisse verschlechtert hat. Den größten Sprung bei der Genauigkeit hat die Datenarbeit gebracht, nicht eine Änderung am Modell.
Zwei gute Läufe, zwei verschiedene Antworten
Welches Modell das beste ist, hängt davon ab, wie man es misst. Das war die wichtigste Erkenntnis aus Stufe B.
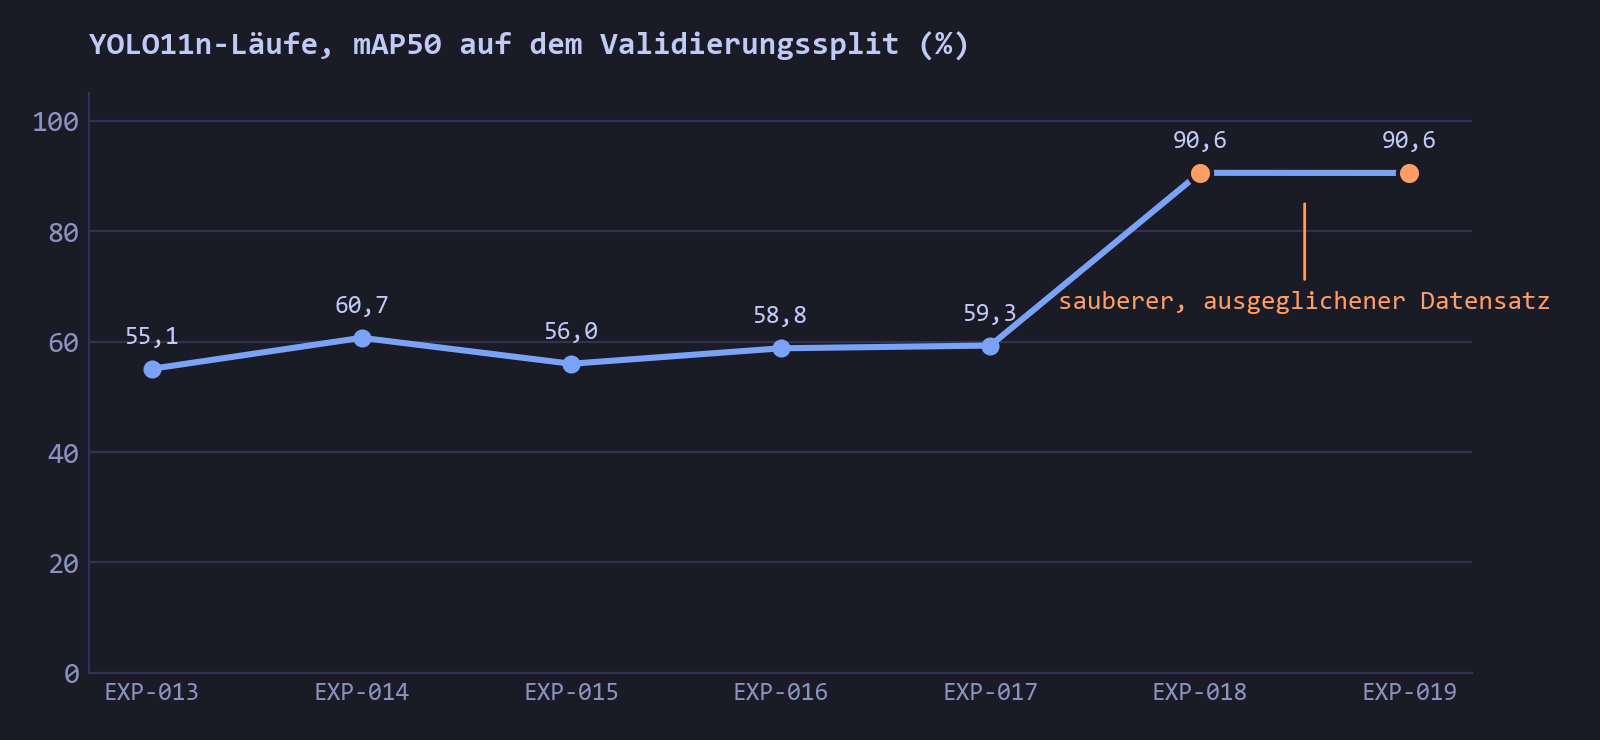
EXP-019 hat die besten Validierungswerte. Es wiederholt EXP-018 auf dem sauberen, klassenausgeglichenen Datensatz und erreicht 90,6 % mAP50 auf dem Split mit 415 Bildern vom Tisch. Beim zweiten Mal kam fast genau dasselbe heraus. Das sind aber saubere Fotos auf einem schlichten Tisch. Der Wert zeigt, dass das Modell diesen Datensatz gut gelernt hat, aber nicht, wie es sich auf einem echten Sortierband verhält. Auf echten Fotos hat es nicht schlecht abgeschnitten, war dort aber auch nicht das beste Modell.
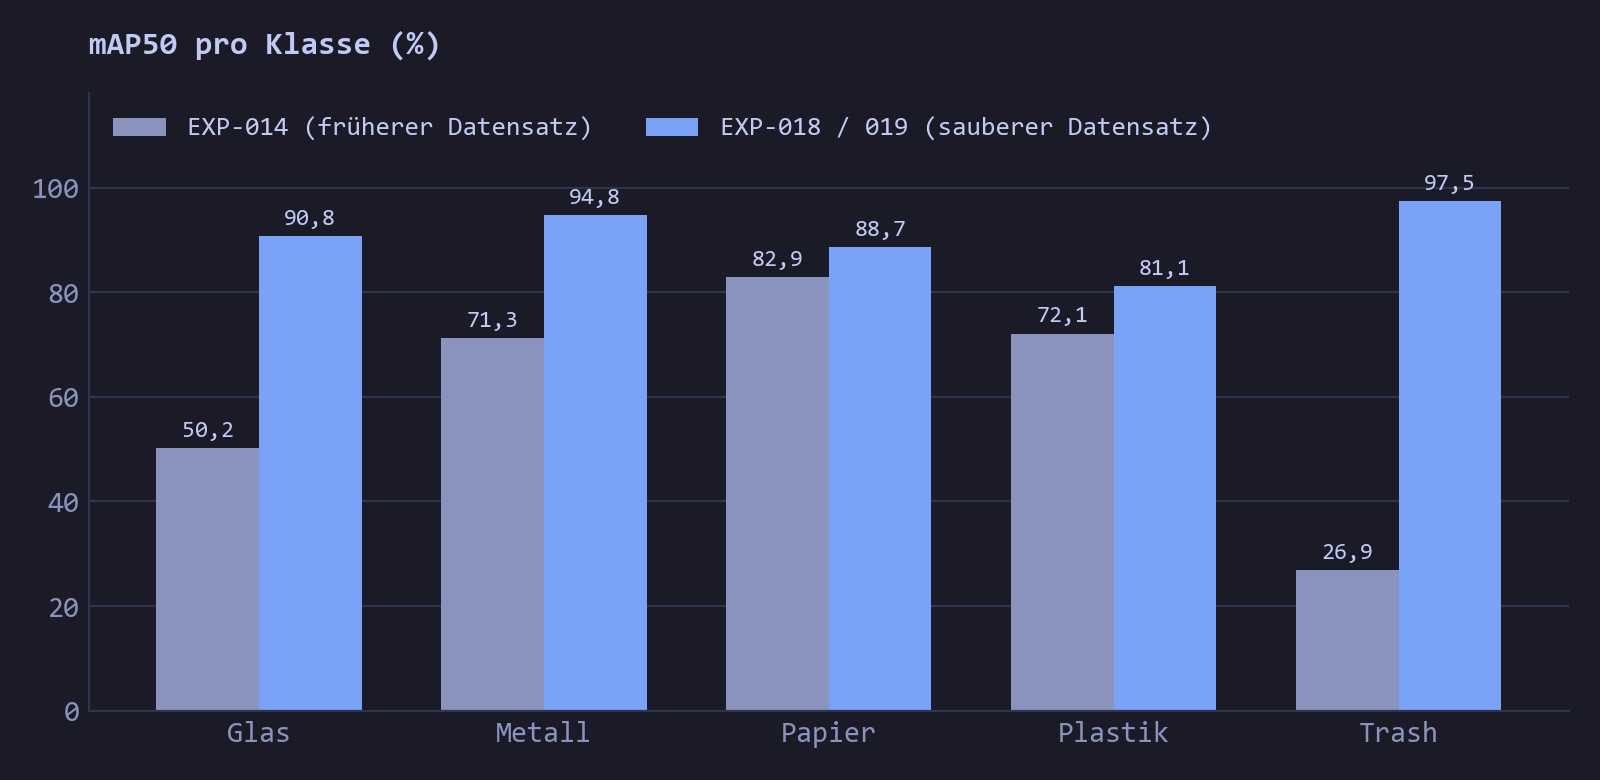
EXP-014 war im Feld-Benchmark am besten, und das hat mich am meisten überrascht. Es wurde auf der älteren Mischung aus TACO, TrashNet und Roboflow trainiert. Auf seinem eigenen Validierungssplit kam es nur auf 60,7 % mAP50. Im Benchmark mit 805 Bildern, der Fotos aus der freien Natur und vom Tisch mischt, erreichte es 85,8 % F1 bei der Klassenpräsenz pro Bild. Das war der beste Wert von 11 getesteten Modellen. Ich führe das auf die wilden Fotos mit gemischtem Hintergrund zurück, mit denen es trainiert wurde. Der F1-Wert für Trash war mit 54 % trotzdem der schwächste. EXP-019 war nicht Teil dieses Benchmarks, und die Benchmark-Bilder sind nicht dieselben wie die 415 Bilder des Splits. Deshalb kann ich die beiden nicht direkt gegeneinander einordnen.
Daraus folgt das nächste Experiment. Auf dem Tischsplit erreicht Trash 97,5 % mAP50, im Feld-Benchmark aber nur 54 % F1. Meine Vermutung: Ein Validierungssatz mit meist einfachen, gut beleuchteten Fotos schönt das Ergebnis, und der Feld-Benchmark kommt dem näher, was ein Sortierer tatsächlich sieht. Bewiesen habe ich das noch nicht.
EXP-020 läuft gerade. Es soll die beiden Richtungen verbinden: den sauberen, ausgeglichenen Datensatz hinter dem Validierungswert von EXP-019 und die Fotos aus der freien Natur mit gemischtem Hintergrund, mit denen EXP-014 im Feld besser funktioniert hat. Ziel ist ein Modell, das den Validierungswert hält und auch im Feld-Benchmark gut abschneidet. Es ist noch nicht protokolliert, deshalb gibt es auf dieser Seite dazu noch keine Zahlen.
Was es heute kann
- Mit der Kommandozeile
miraläuft die Live-Erkennung von einer Webcam oder einem IP/RTSP-Stream, optional mit ByteTrack-Tracking. - Ein lokales Dashboard mit FastAPI und einer Web-Oberfläche zeigt Erkennungen, Klassenzahlen, FPS, Latenz, CPU und Speicher.
- Es gibt Werkzeuge zum Bauen von Datensätzen, zum Auswerten der Modelle und für den Feld-Benchmark. Dahinter stehen etwa 25 Testdateien.
- Exporte nach ONNX und LiteRT/TFLite bei 320 und 640 Pixeln. Das Paket
mira-aiauf PyPI enthält die Modelle, und die Gewichte liegen auf Hugging Face.
In Zahlen
- Protokollierte Experimente
- 19 (EXP-001 bis EXP-019), jedes mit Einstellungen und Ergebnis im Log; EXP-020 läuft gerade
- Feld-Benchmark
- EXP-014 mit 85,8 % F1 pro Bild (92,9 % Präzision, 79,7 % Recall) auf 805 Bildern, der beste von 11 getesteten Modellen
- Endgültiger Datensatz
- 6.898 Bilder und 12.832 Boxen (5.108 Training, 415 Validierung, 1.375 Test)
- Modell
- YOLO11n, 2,58 Millionen Parameter und 6,3 GFLOPs
- Bestes Validierungsergebnis
- 90,6 % mAP50 und 82,2 % mAP50-95 auf dem Validierungssplit mit 415 Bildern, in einem zweiten Lauf mit 90,58 % wiederholt
- Vor dem Neubau des Datensatzes
- 60,7 % mAP50 (EXP-014)
- Größe des endgültigen Modells
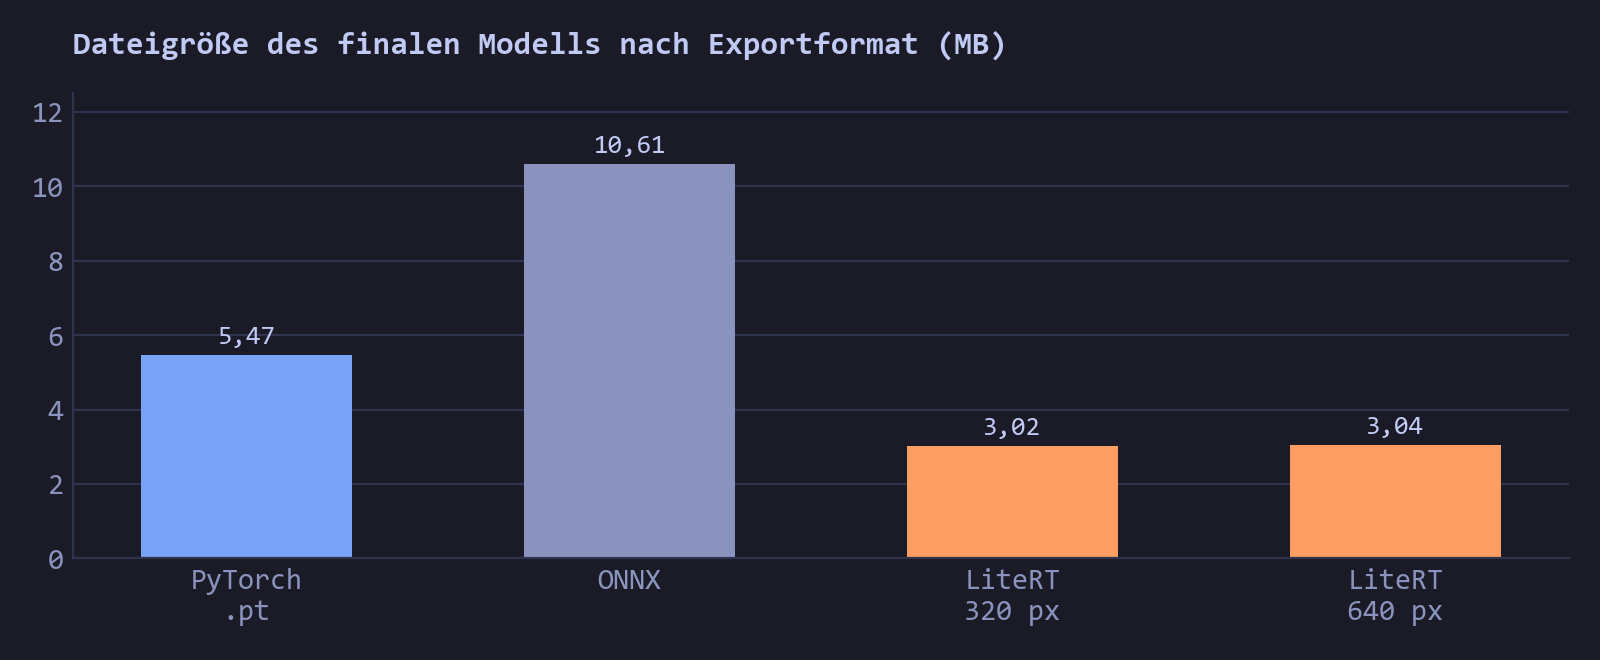
- 5,47 MB als PyTorch-Gewichte, 3,02 MB als LiteRT-Datei mit 320 Pixeln
- LiteRT-Export mit 320 Pixeln
- 86,2 % mAP50, die kleinere Datei verliert also etwa 4 Punkte
- Geschwindigkeit
- 1,5 bis 3,6 ms pro Bild auf einer T4-GPU; noch keine Messung auf einem Raspberry Pi
- Downloads
- über 6.500 Modell-Downloads auf Hugging Face insgesamt (ein Download-Zähler, keine Zahl von Personen)
Abbildungen
Aktueller Stand
Der Sortierroboter ist noch nicht fertig, und auf einem Raspberry Pi hat bisher nichts gelaufen. EXP-020 trainiert noch und hat deshalb noch keine protokollierten Ergebnisse.
Die 90,6 % stammen von einem Validierungssplit im Stil von TrashNet, also von Tischaufnahmen, die im Vergleich zu einer echten Sortierstrecke einfach sind. Der Testsplit mit 1.375 Bildern wurde für die endgültigen Läufe nicht ausgewertet. Der Feld-Benchmark prüft nur, ob eine Klasse im Bild vorkommt, nicht wo sie liegt. Deshalb sagt er wenig über die Qualität der Erkennung. Quantisierte Exporte verlieren Genauigkeit, wie das LiteRT-Ergebnis mit 320 Pixeln zeigt. Zerknülltes Papier, überlappende Objekte, Dosen, die man von der Öffnung her sieht, und ungewöhnliches Licht bleiben schwierige Fälle. Ein gutes Ergebnis auf dem Datensatz ist keine Garantie für echtes Sortieren. Die README sagt außerdem, dass KI-Werkzeuge bei Teilen des Programmierens und Debuggens geholfen haben.