MobileNet on FPGA
Ich prüfe, wie weit sich ein kleines neuronales Netz auf 8-Bit-Ganzzahlen und Richtung Hardware drücken lässt, bevor jemand dafür etwas entwirft.
Warum es existiert
Das Projekt kam aus meiner Arbeit mit Leuten aus dem Umfeld des Lehrstuhls für Elektronische Bauelemente und Schaltungen (EBS) an der Universität Duisburg-Essen. Ich habe mir MobileNet V1 und V2, Edge-KI und Quantisierung angeschaut und überlegt, was nötig wäre, um so ein Netz auf einem FPGA laufen zu lassen.
Die Frage klingt einfach: Wie viel Genauigkeit bleibt übrig, wenn man ein kleines Netz in 8-Bit-Ganzzahlen umwandelt? Hardware verarbeitet genau diese Form am einfachsten. Bleibt die Genauigkeit fast gleich, lohnt sich ein Beschleuniger. Bricht sie stark ein, muss der Entwurf anders aussehen. Deshalb sollte die Antwort vorliegen, bevor jemand die Hardware zeichnet.
Wie es funktioniert
Das ist die Softwarehälfte des Weges zur Hardware. Zwei kleine Netze werden trainiert, quantisiert und untersucht, damit die Hardwareseite echte Zahlen hat, mit denen sie planen kann, statt nur zu raten.
Was ich gebaut habe
- Ich habe die Keras-Versionen von MobileNetV1 (13 tiefenweise trennbare Blöcke) und MobileNetV2 (17 invertierte Residualblöcke) selbst geschrieben, mit einem Breitenfaktor von 0,5 und einer Eingabe von 128 mal 128 Pixeln.
- Ich habe auf CIFAR-10 trainiert: 45.000 Trainings-, 5.000 Validierungs- und 10.000 Testbilder, von 32 auf 128 Pixel hochskaliert. Das lief in einem Kaggle-GPU-Notebook mit frühem Abbruch.
- Danach habe ich eine vollständige ganzzahlige Quantisierung nach dem Training zu TFLite gemacht, kalibriert mit 200 Trainingsbildern und mit INT8-Ein- und Ausgabe.
- Ein Auswertungsskript lässt das INT8-Modell über den TFLite-Interpreter auf allen 10.000 Testbildern laufen. Außerdem habe ich die umgewandelten Graphen Schicht für Schicht durchgesehen, also Tensortypen, Formen und Skalen.
- Ich habe auch die Bitbreiten analysiert. Das größte Produkt zweier INT8-Werte passt in 15 Bit. Die Akkumulatoren brauchen 19 bis 25 Bit, der breiteste liegt im Klassifikator von V2, der 640 Produkte aufsummiert. Ein 32-Bit-Akkumulator hat dort also Reserven.
Was es nicht ist
Eine FPGA-Implementierung gehört nicht zum Umfang des Repositorys. Es gibt keinen HDL- oder HLS-Code, keine Ressourcenabschätzung und keine Latenzmessung. Der Titel beschreibt die Richtung der Arbeit, aber keinen fertigen Einsatz.
In Zahlen
- Genauigkeit auf den 10.000 CIFAR-10-Testbildern
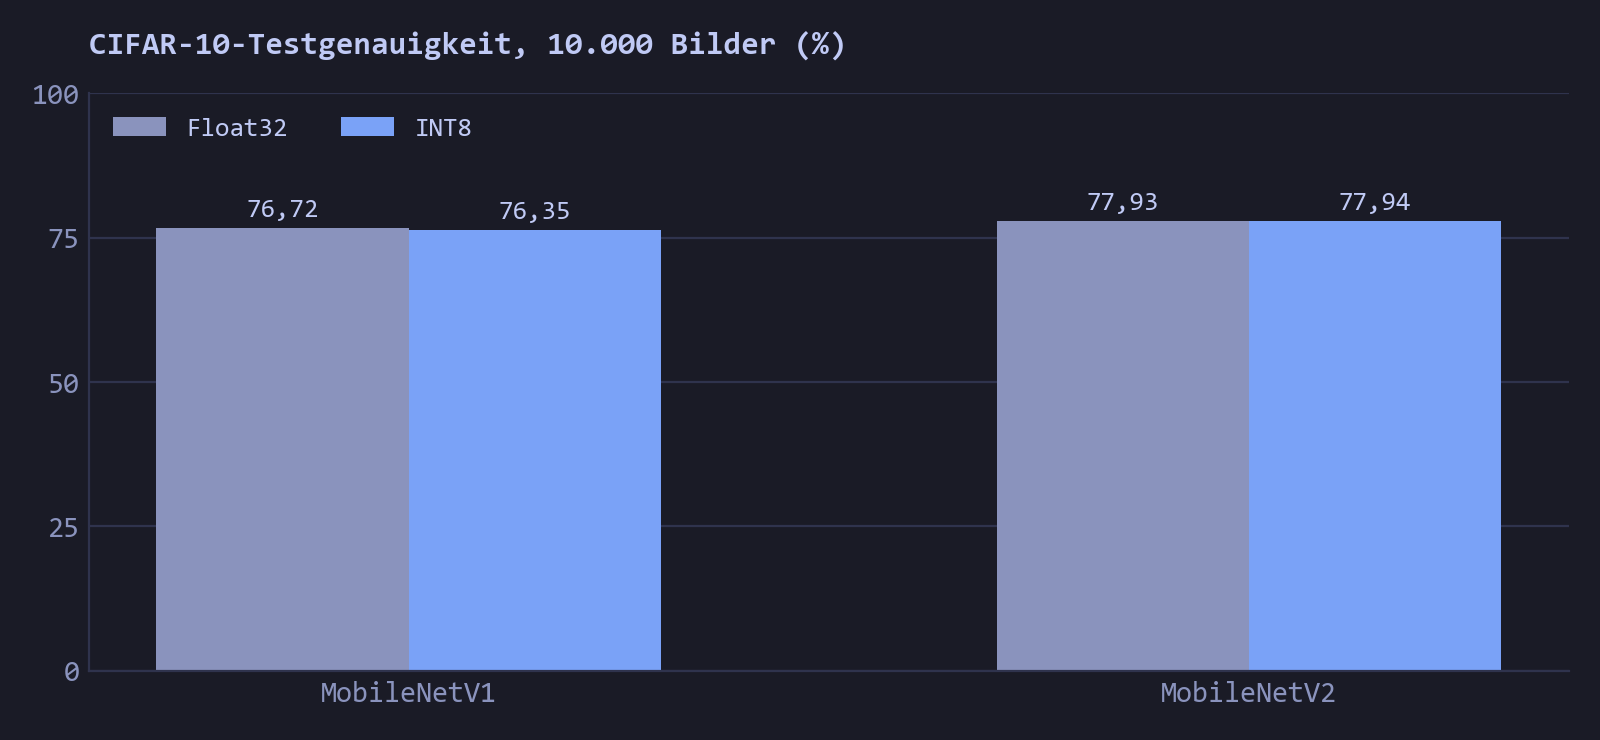
- V1 76,72 % als Float32 und 76,35 % als INT8; V2 77,93 % als Float32 und 77,94 % als INT8
- Größe der TFLite-Datei
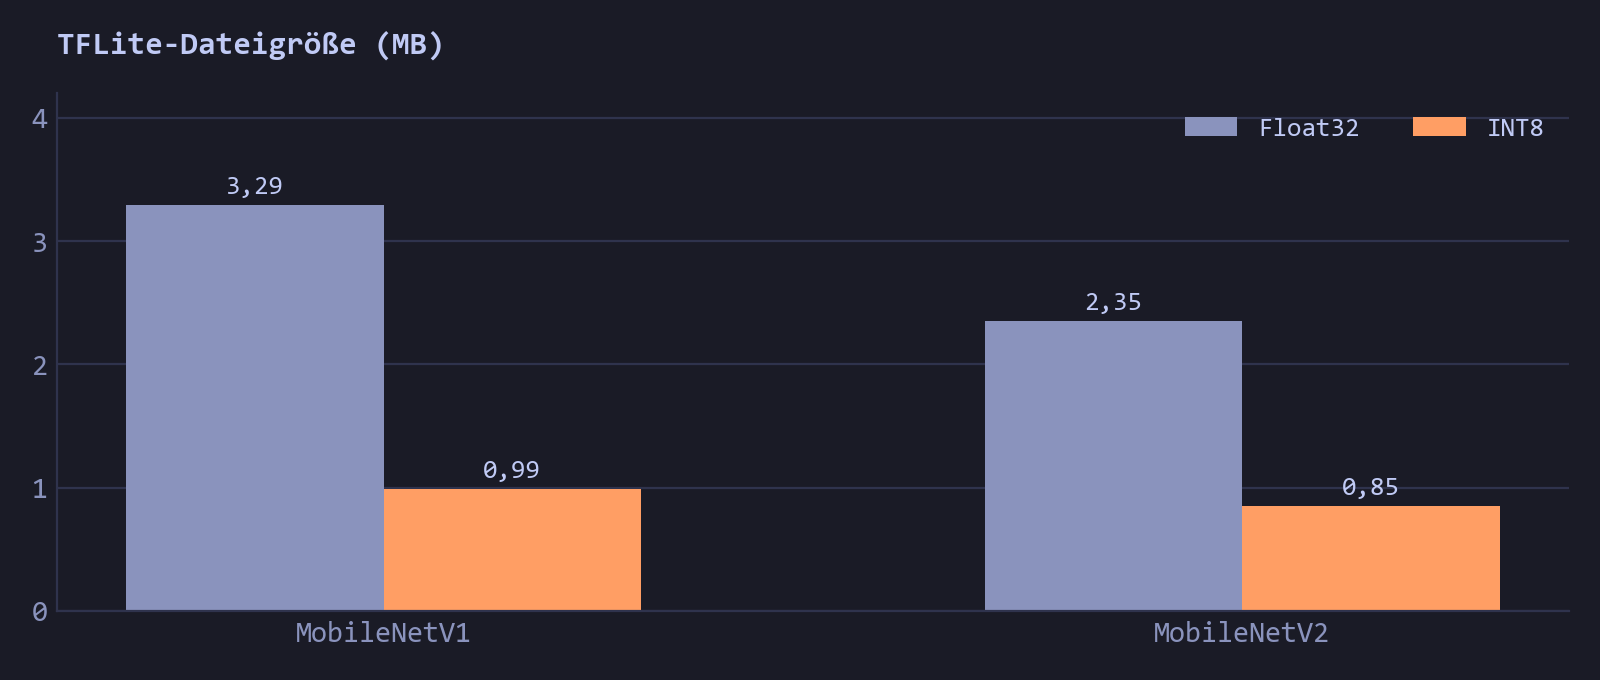
- V1 von 3,29 MB auf 0,99 MB (3,34-mal kleiner); V2 von 2,35 MB auf 0,85 MB (2,78-mal kleiner)
- Parameter in Keras
- V1 834.666 und V2 604.234, also 27,6 % weniger
- Training
- Adam mit 1e-3, Batchgröße 128, früh gestoppt nach 26 Epochen (V1) und 23 Epochen (V2), ein Zufalls-Seed
- Quantisierung
- vollständig ganzzahlig nach dem Training, 200 Kalibrierbilder
- Bitbreiten
- Produkte 15 Bit, Akkumulatoren 19 bis 25 Bit, Biases 32 Bit
- Nicht gemessen
- Latenz, Anzahl der Multiply-Accumulate-Operationen und FPGA-Ressourcen
Abbildungen
Aktueller Stand
Das Projekt ist in Arbeit. Den Teil mit Modell und Quantisierung gibt es, den FPGA-Teil aber nicht. Deshalb gibt es kein Hardwareziel und keine Latenz- oder Ressourcenwerte.
Ich habe auch die Schwachstellen meiner Methode aufgeschrieben, weil sie bestimmen, wie viel die Zahlen wert sind. Die Kalibrierbilder sind die ersten 200 des Trainingspools, und bei diesem Seed gehören 25 davon zum Validierungssplit. Die Auswertung quantisiert die Eingabe durch Abschneiden statt durch Runden. Es gibt nur einen Seed, und die Trainingsgenauigkeit nähert sich 100 %, das ist Überanpassung. Außerdem sind die Bilder von 32 Pixeln hochskaliert und enthalten deshalb weniger Details, als die Eingabe des Netzes vermuten lässt.
Als Nächstes kommen mehrere Seeds, eine Kalibrierung nur aus dem Trainingssplit und ein Latenzwert auf einem benannten Zielgerät.
Links
Der Quellcode ist öffentlich, enthält aber keinen HDL- oder HLS-Code. Er belegt keine fertige FPGA-Implementierung.